Anthropic udostępnił Claude Fable 5.2 i Mythos 5.2, dwa warianty tego samego bazowego modelu, które różnią się przede wszystkim zabezpieczeniami i zasadami dostępu. Przyglądamy się tej premierze z perspektywy firm, ponieważ producent łączy wysoką autonomię w pracy z kodem z ograniczeniami dotyczącymi cyberbezpieczeństwa i biologii. Istotne są również ceny oraz dostępność przez największe platformy chmurowe.
Fable 5.2 i Mythos 5.2 różnią zasady dostępu
Fable 5.2 ma być wariantem przeznaczonym do szerszego wykorzystania. Anthropic ograniczył w nim zadania wysokiego ryzyka związane z cyberbezpieczeństwem, a także większość zadań badawczych z obszaru biologii. Zabezpieczenia mają utrudniać użycie modelu do atakowania infrastruktury informatycznej lub prowadzenia niebezpiecznych prac biologicznych.
Mythos 5.2 korzysta z tego samego modelu bazowego, ale daje zweryfikowanym organizacjom szerszy zakres możliwości. Nie jest to więc zwykły wyższy pakiet abonamentowy. Dostęp zależy od przejścia procedury weryfikacyjnej odpowiedniej dla planowanego zastosowania.
- Fable 5.2 blokuje zadania cyberbezpieczeństwa uznane za obarczone wysokim ryzykiem.
- Fable 5.2 ogranicza większość zadań badawczych związanych z biologią.
- Mythos 5.2 jest dostępny przez Cyber Verification Program lub Life Sciences Verification Program.
- Klienci Enterprise mogą korzystać z Mythos 5.2 w Claude Security do skanowania kodu, ale nie otrzymują w ten sposób pełnego dostępu do modelu.
Widzimy tu wyraźny podział oparty na ryzyku zastosowania, a nie wyłącznie na cenie lub wielkości klienta. Organizacja musi wykazać, dlaczego potrzebuje funkcji, które w publicznie dostępnym wariancie pozostają zablokowane. Dla zespołów bezpieczeństwa oznacza to konieczność uwzględnienia procesu weryfikacji już na etapie planowania projektu.
Osiem dni pracy agentów zakończyło się prototypem systemu
Jednym z testów Fable 5.2 było przygotowanie od podstaw prototypu systemu operacyjnego. Przez osiem dni model koordynował agentów odpowiedzialnych za pisanie kodu, testowanie go i sprawdzanie rezultatów. Eksperyment pokazuje więc nie tylko generowanie pojedynczych fragmentów programu, lecz także zarządzanie wieloetapową pracą innych agentów.
Powstałe oprogramowanie działało na laptopie. Prototyp obejmował własne jądro systemu, sterowniki dysku, klawiatury i sieci, mechanizm przechowywania plików oraz graficzny interfejs okienkowy. Dodano również ekran logowania, instalator i wbudowane funkcje Claude.
Traktujemy ten wynik jako demonstrację możliwości, a nie gotowy system przeznaczony do środowiska produkcyjnego. Sam fakt uruchomienia prototypu nie mówi, jak rozwiązanie radzi sobie z bezpieczeństwem, aktualizacjami, awariami czy długotrwałym obciążeniem. Nie podano również parametrów laptopa ani szczegółowej metody oceny jakości kodu.
Z punktu widzenia automatyzacji najciekawsza jest rola modelu jako koordynatora. Fable 5.2 nie miał wykonywać jednego polecenia, lecz rozdzielać zadania, kontrolować testy i prowadzić projekt przez kolejne etapy. To właśnie taki sposób działania odróżnia system agentowy od klasycznego asystenta odpowiadającego na pojedyncze zapytania.
Formalizacja twierdzenia Fermata zajęła 30 godzin
Drugim opisanym eksperymentem była formalizacja dowodu wielkiego twierdzenia Fermata. Anthropic podaje, że Fable 5.2 wykonał to zadanie w 30 godzin przy minimalnym udziale człowieka. Nie chodziło o stworzenie swobodnego opisu dowodu, lecz o zapisanie go w języku Lean.
Lean służy do formalnego zapisywania rozumowania matematycznego w sposób, który pozwala komputerowi sprawdzać kolejne kroki. Każda zależność musi zostać przedstawiona wystarczająco precyzyjnie, aby system mógł potwierdzić jej poprawność. Taka praca wymaga konsekwentnego utrzymywania struktury dowodu oraz usuwania błędów wykrywanych przez narzędzie weryfikujące.
Ten rezultat wskazuje na zdolność modelu do długiej pracy nad zadaniem wymagającym kontroli logicznej. Nie znamy jednak dokładnego zakresu udziału człowieka, konfiguracji środowiska ani procedury końcowej oceny. Bez tych informacji nie możemy porównać eksperymentu z innymi próbami formalizacji dowodów matematycznych.
Ile kosztują modele i gdzie można ich używać
Standardowa cena Fable 5.2 i Mythos 5.2 wynosi 8 dolarów za milion tokenów wejściowych oraz 40 dolarów za milion tokenów wyjściowych. Opcjonalny tryb szybki kosztuje odpowiednio 16 i 80 dolarów. Według podanych parametrów model generuje wtedy tokeny około 2,5 raza szybciej.
Różnica między ceną wejścia i wyjścia ma znaczenie przy projektowaniu automatyzacji. Proces przesyłający dużo dokumentów, ale zwracający krótką odpowiedź, będzie miał inny profil kosztowy niż agent generujący obszerny kod, dokumentację i raporty z testów. Dlatego przed wdrożeniem policzylibyśmy osobno tokeny wejściowe i wyjściowe dla rzeczywistych przypadków użycia.
Fable 5.2 jest dostępny w Claude oraz za pośrednictwem Amazon Web Services, Google Cloud i Microsoft Azure. Model ma obsługiwać przede wszystkim najtrudniejsze zadania, które wymagają dużych nakładów obliczeniowych i długiego utrzymywania celu. Anthropic pozostawia typowe zadania modelowi Opus 5.5.
Fable 5.2 prowadzi w indeksie, ale koszt zależy od trybu
Claude Fable 5.2 w trybie max uzyskał około 65 punktów przy ważonym średnim koszcie około 27 dolarów na zadanie. To najwyższy wynik w zestawieniu Artificial Analysis. Ten sam model w trybie xhigh osiąga około 62 punkty za około 9 dolarów, w high 57-58 punktów za około 6 dolarów, a w medium około 56 punktów za mniej niż 4 dolary. Są to tryby pracy (effort) jednego modelu, a nie osobne generacje.
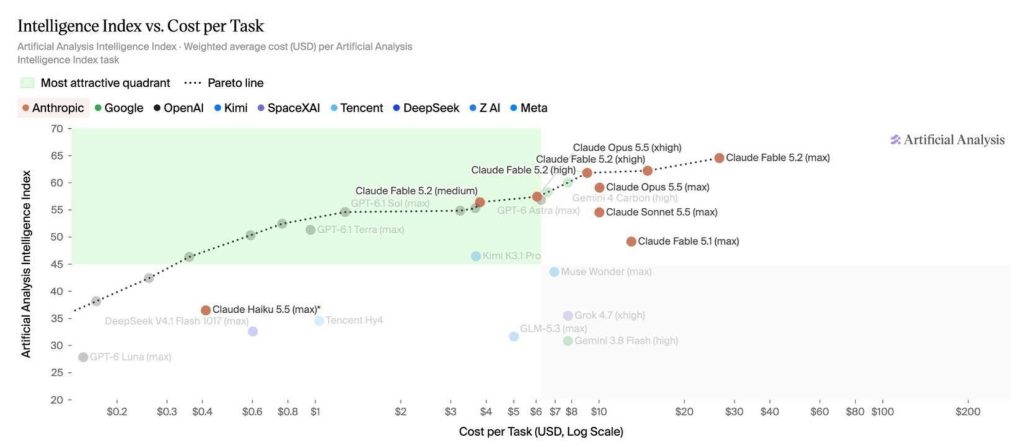
Oś pionowa przedstawia wynik Intelligence Index, a pozioma koszt wykonania zadania. Oś kosztu ma skalę logarytmiczną, więc równa odległość nie oznacza stałego przyrostu w dolarach. Najkorzystniej wypadają punkty położone wysoko i po lewej stronie. Każdy punkt odpowiada konkretnej konfiguracji modelu, dlatego zmiana trybu effort przesuwa zarówno wynik, jak i koszt.
Tryb max daje około 3 punkty więcej niż xhigh, ale kosztuje około trzy razy więcej. Medium traci około 9 punktów do max, za to koszt zadania spada z około 27 dolarów do mniej niż 4 dolarów. Nie każde zadanie wymaga więc najmocniejszej konfiguracji. Czasem lepszy stosunek kosztu do wyniku zapewni tańszy tryb lub kilka tańszych modeli uruchomionych równolegle. W pilotażu porównalibyśmy te warianty na tym samym procesie, mierząc jakość, liczbę poprawek i pełny koszt wykonania zadania.
Czym jest Artificial Analysis Intelligence Index
Artificial Analysis prowadzi niezależny ranking modeli AI. Intelligence Index łączy wyniki z 9 testów w czterech obszarach. Każdy odpowiada za 25% wyniku:
- Wiedza i praca biurowa - 25%: analiza dokumentów, raporty, arkusze kalkulacyjne, prezentacje i zadania w aplikacjach firmowych.
- Programowanie - 25%: rzeczywiste problemy w kodzie, naprawianie błędów, terminal i modyfikowanie istniejących projektów.
- Nauka - 25%: trudne zadania z fizyki, matematyki i innych dziedzin, w tym analizy oraz pisanie kodu.
- Wiedza ogólna - 25%: poprawność odpowiedzi, rozumowanie i sprawdzanie, czy model nie wymyśla faktów.
Przykładowe zadanie polega na przeniesieniu działającej aplikacji z MySQL do PostgreSQL bez przerywania jej działania i bez utraty danych. Model musi wykonać pracę, a nie ograniczyć się do opisania rozwiązania.
Wynik 65 punktów jest rezultatem zbiorczym w tym zestawie testów. Nie oznacza, że model osiągnął 65% inteligencji człowieka. Powinien służyć do porównywania modeli w opisanych obszarach, a nie jako miara ludzkiej inteligencji.
Co to znaczy dla polskich firm
Dla polskich organizacji najważniejsza jest dostępność Fable 5.2 przez popularne platformy chmurowe. Zespół korzystający już z Amazon Web Services, Google Cloud lub Microsoft Azure może rozważyć test bez budowania osobnego środowiska dostępowego. Nie oznacza to jednak, że model automatycznie spełni wewnętrzne wymagania dotyczące poufności danych, kontroli dostępu i rejestrowania operacji.
Naszym zdaniem pierwszym rozsądnym zastosowaniem będzie ograniczony pilotaż dotyczący złożonego zadania programistycznego. Można porównać czas pracy, liczbę poprawek, koszt tokenów i zakres nadzoru człowieka z obecnym procesem. Eksperyment z systemem operacyjnym sugeruje, że model warto oceniać jako koordynatora agentów, ale nie dowodzi jeszcze gotowości do samodzielnego utrzymywania systemów produkcyjnych.
Firmy zajmujące się cyberbezpieczeństwem lub badaniami biologicznymi muszą dodatkowo uwzględnić procedury dostępu do Mythos 5.2. Sam zakup usługi Enterprise nie otwiera wszystkich funkcji. Korzystanie z modelu w Claude Security pozwala skanować kod pod kątem podatności, lecz pozostaje ograniczonym sposobem dostępu.
W praktyce rozdzielilibyśmy ocenę na trzy obszary: jakość rezultatów, całkowity koszt procesu i ryzyko operacyjne. Cena za milion tokenów jest tylko jednym składnikiem. Równie ważne pozostają czas specjalistów potrzebny do kontroli wyników, możliwość odtworzenia działań agentów oraz procedura zatrzymania automatyzacji, gdy model wybierze błędny kierunek.